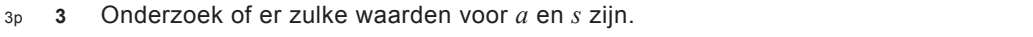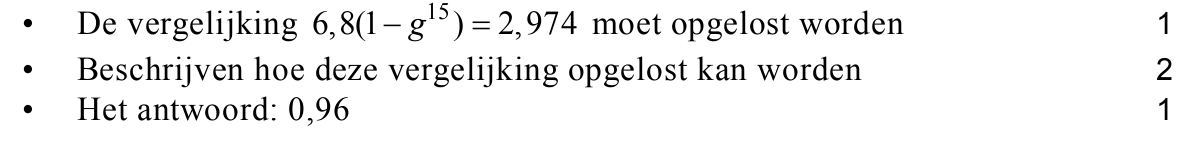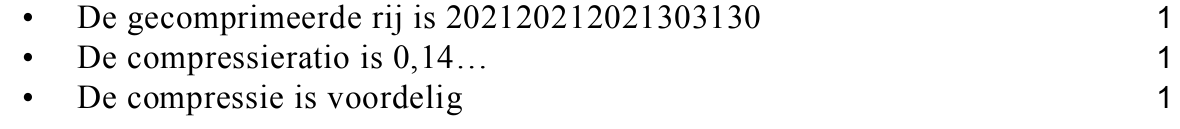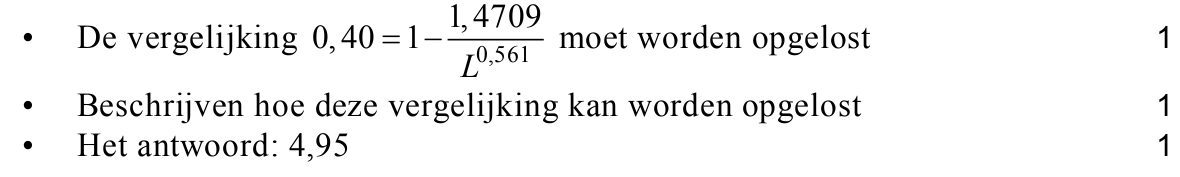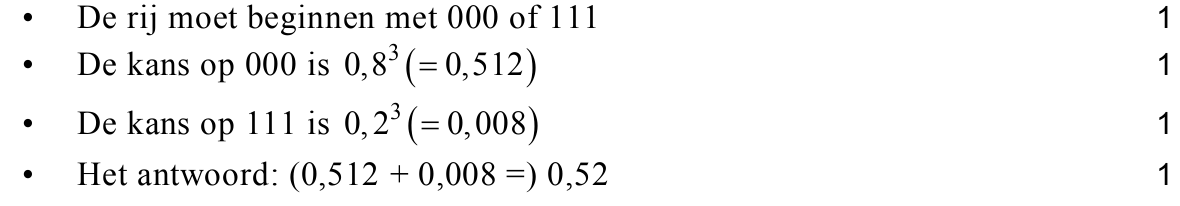opgave 2Bridgedrive
Bridge is een kaartspel waarbij een team van twee spelers tegen een
ander team van twee spelers speelt. Zo’n team van twee spelers heet een
paar. De Oldenzaalse Bridge Club organiseert ieder jaar een bridgedrive
(een toernooi) waar een groot aantal paren aan deelneemt.
Aan de bridgedrive van 2008 namen 192 paren deel. Elk paar speelde
acht rondes waarin ze in elke ronde vier spellen speelden. Nadat elk paar
deze 32 spellen had gespeeld werden de eindscores bepaald. Het paar
met de hoogste eindscore werd de winnaar.
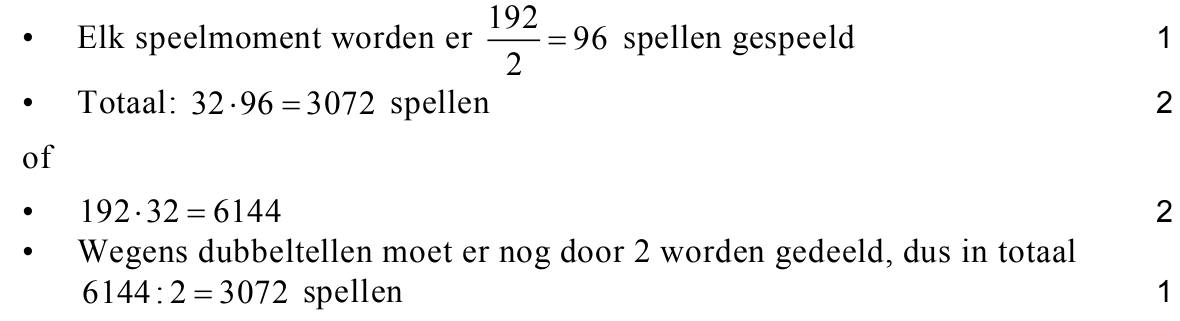
53pBereken hoeveel keer er tijdens deze bridgedrive een spelletje bridge
werd gespeeld.
De bridgedrive wordt gespeeld op 16 verschillende horecalocaties in
Oldenzaal. Op elke locatie spelen evenveel paren. Na vier spellen
wisselen de paren van locatie volgens een schema dat de spelers van
tevoren niet bekend is.
Het paar Hendriks-Hendriks zit klaar voor de eerste ronde. Zij vragen zich
af of het paar Van Zomeren-Zenderink tijdens de eerste ronde op dezelfde
locatie speelt.
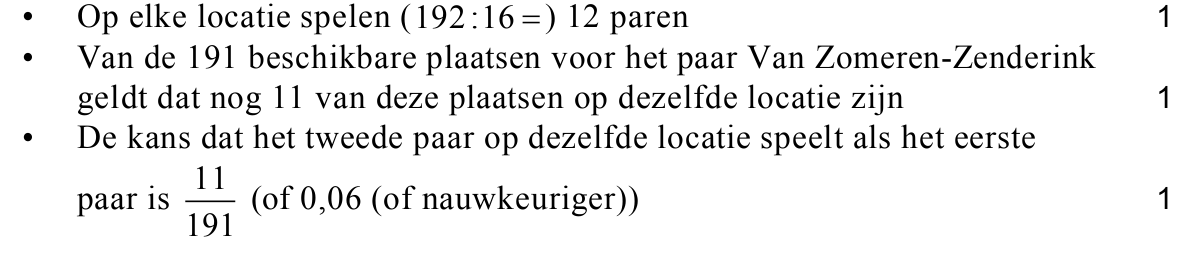
63pBereken de kans dat het paar Van Zomeren-Zenderink de eerste ronde op
dezelfde locatie speelt als het paar Hendriks-Hendriks.
Per spel krijgt elk paar een score op een schaal van 0 tot en met 100.
Na afloop van de drive wordt voor elk paar de totale score gedeeld door
het aantal gespeelde spellen. Dit geeft een eindscore die wordt afgerond
op twee decimalen. Het paar met de hoogste eindscore krijgt positie 1 en
wint de hoofdprijs.
We nemen aan dat in 2008 de eindscores normaal verdeeld waren met
gemiddelde 50,00 en standaardafwijking 7,12. Het paar Hendriks-
Hendriks had een eindscore van 54,66.
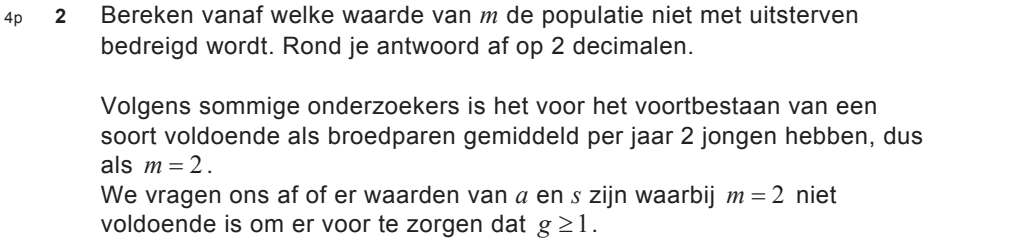
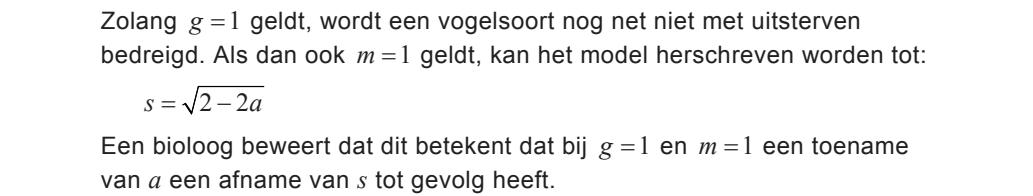
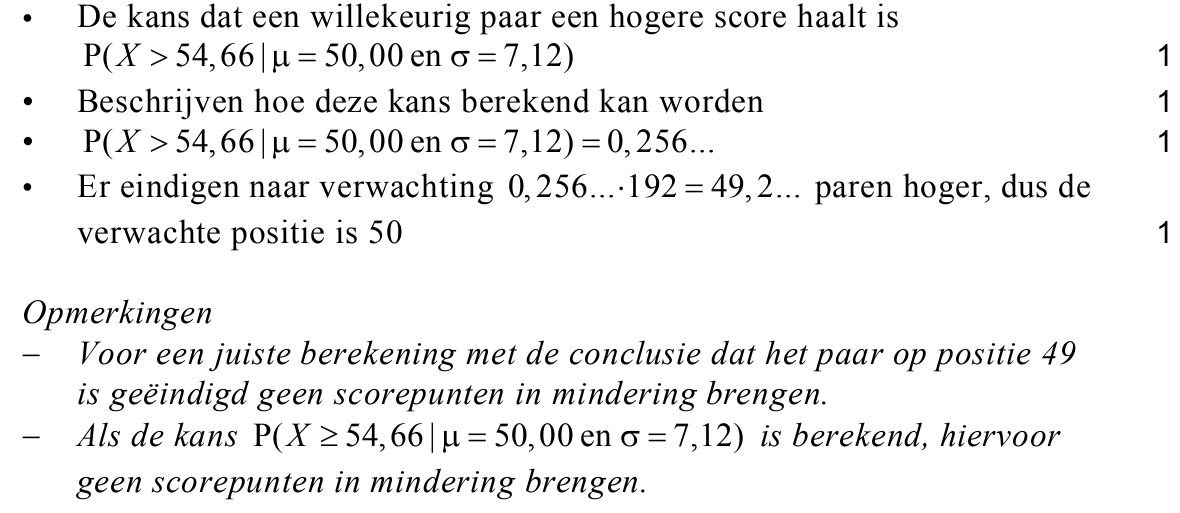
74pBereken op grond hiervan de positie van dit paar in de eindklassering.
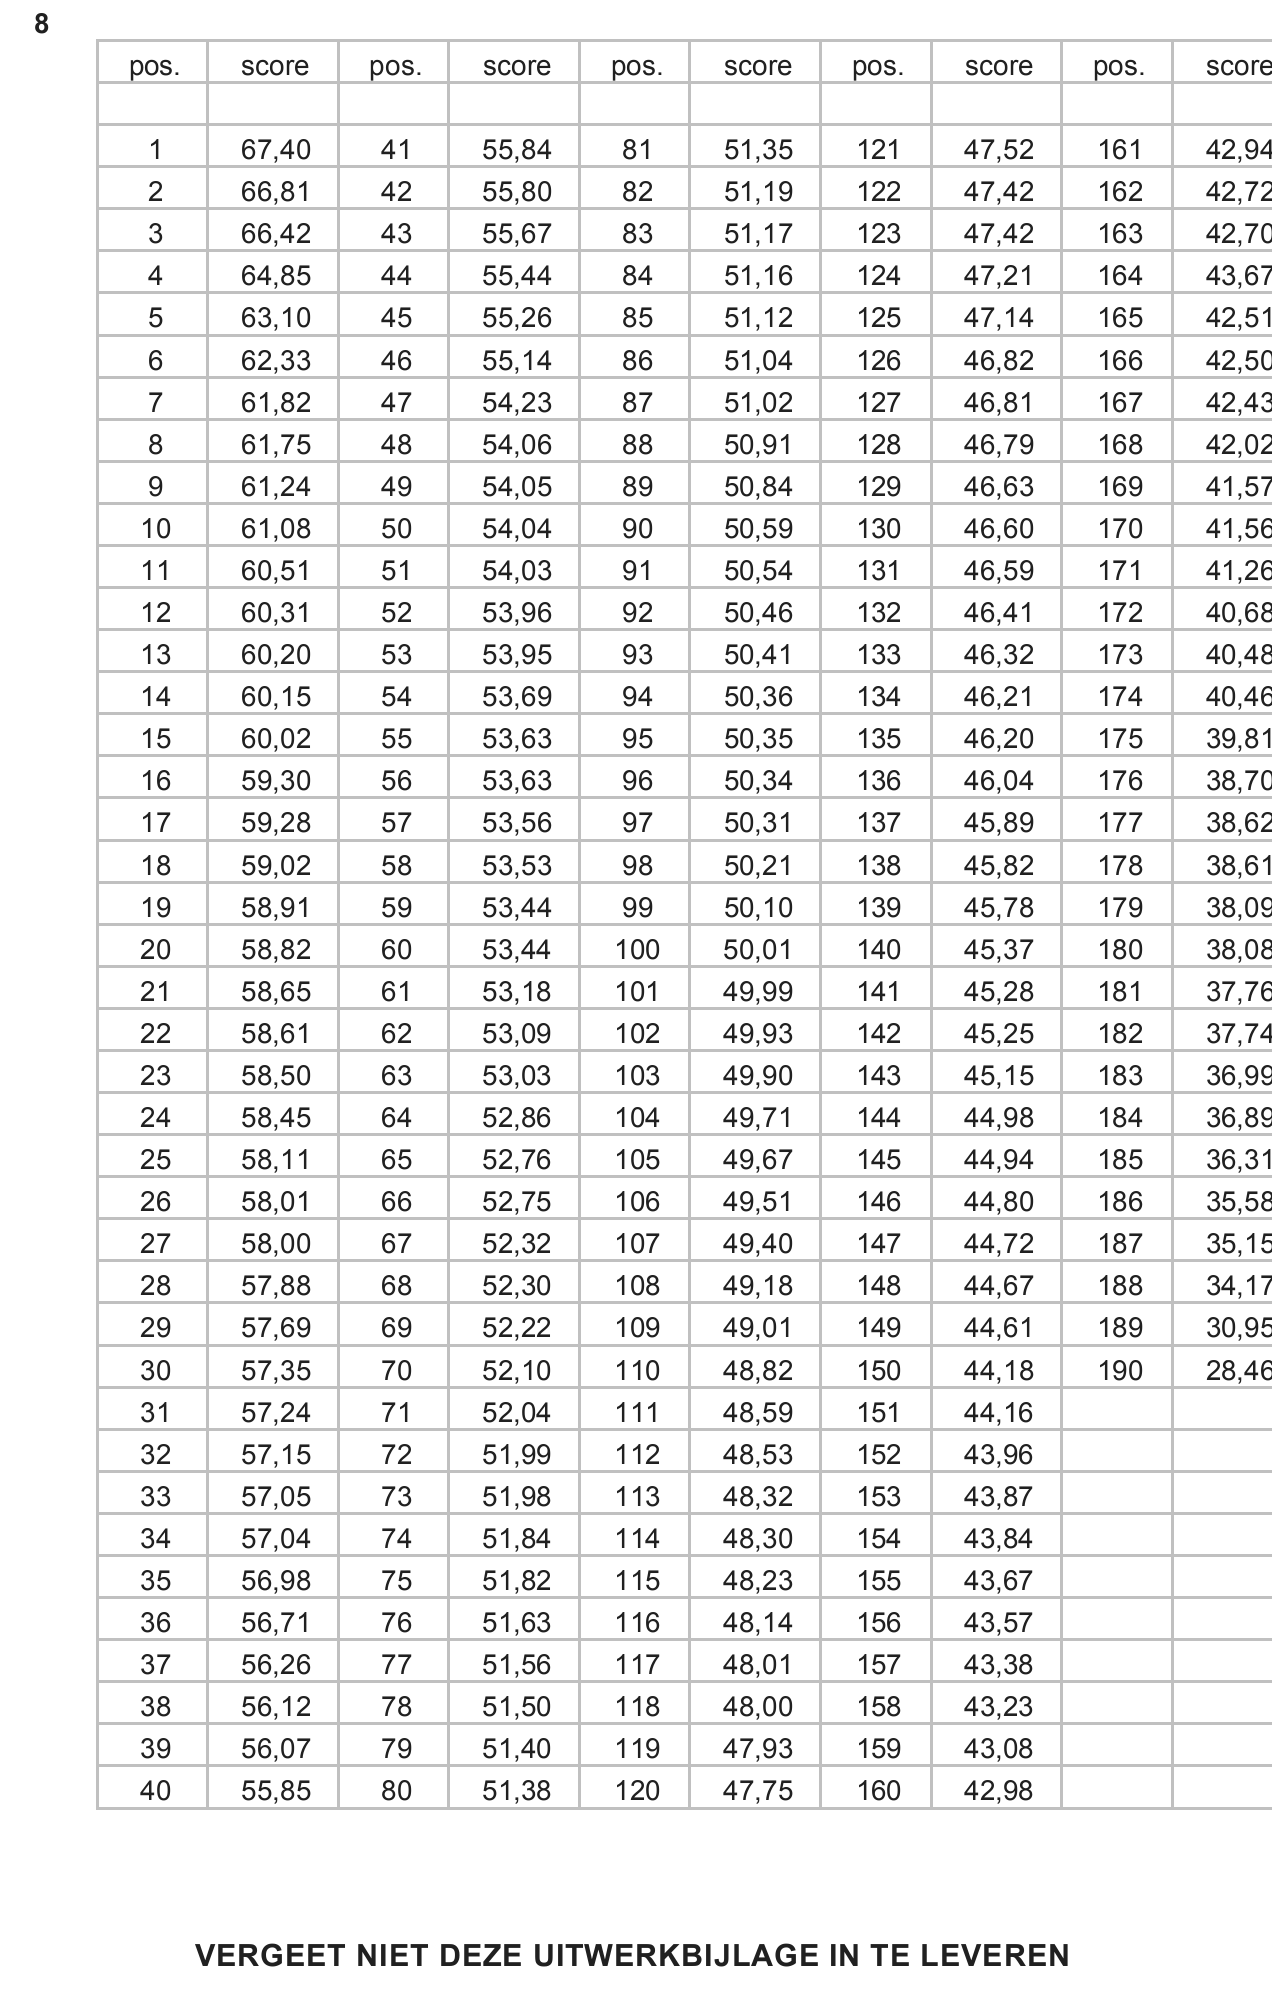
In 2007 namen 190 paren deel aan de drive. Hun eindscores staan in een
tabel op de uitwerkbijlage. Het gemiddelde van deze eindscores is 49,93
en de standaardafwijking is 7,07.
Men vraagt zich af of deze scores ook bij benadering normaal verdeeld
zijn. Dit is te onderzoeken door te controleren of deze gegevens in
overeenstemming zijn met onder andere de volgende drie regels voor de
normale verdeling:
1 de 68%-vuistregel;
2 de 95%-vuistregel;
3 de mediaan is gelijk aan het gemiddelde.
Aan de eerste regel (de 68%-vuistregel) is voldaan.
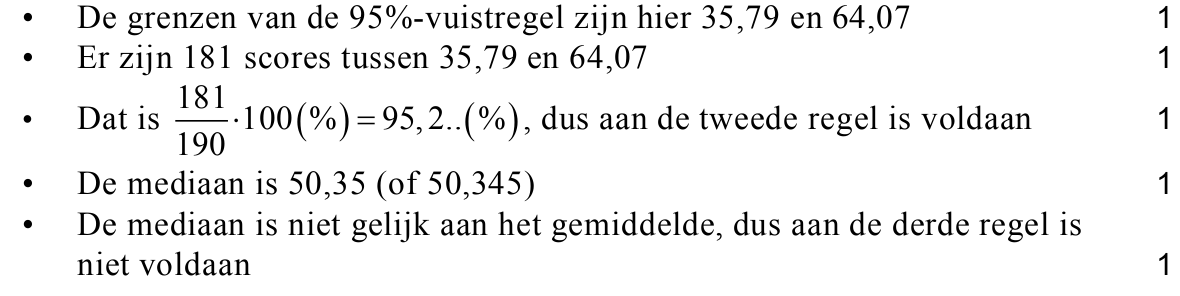
85puitwerkbijlageOnderzoek of de scores in de tabel op de uitwerkbijlage ook aan elk van
de andere twee regels voldoen.
Het paar Fussel-Stoffer neemt voor het eerst deel. Gezien hun grote
ervaring bij andere bridgetoernooien verwachten zij zelf een hoge
klassering. “Tegen zulke tegenstanders hebben wij in ieder spel 80% kans
op een score van 60 punten of meer”, zo menen zij. Een toeschouwer
vindt dit paar niet zo sterk en twijfelt aan deze uitspraak. Zij volgt de
eerste 16 spellen. Op die spellen blijkt het paar 10 keer een score van 60
punten of meer gehaald te hebben.
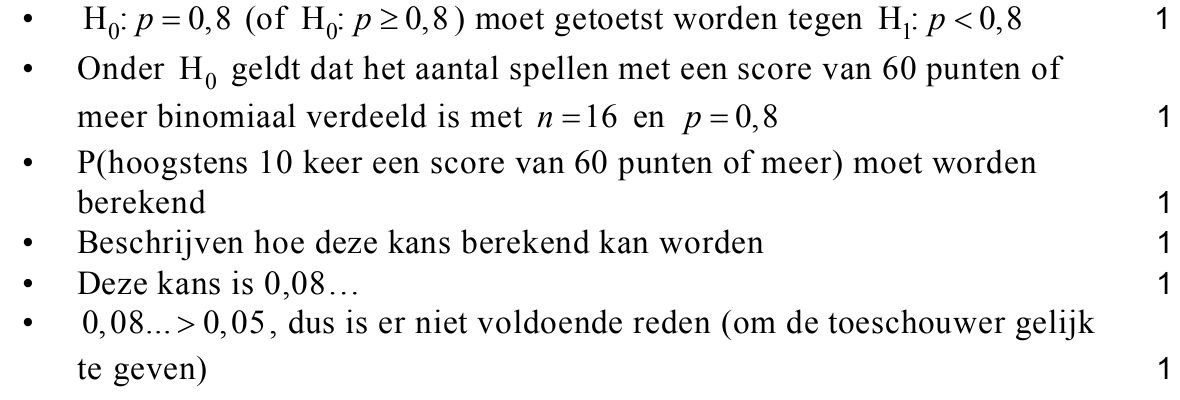
96pFormuleer een hypothesetoets en onderzoek of dit resultaat voldoende
reden geeft om de toeschouwer gelijk te geven. Neem een
significantieniveau van 5%.
opgave 3Talen
De wereldbevolking bedroeg in 2010 ongeveer 6800 miljoen (6,8 miljard)
mensen. Volgens schattingen uit dat jaar werden er toen op de wereld
ruim 500 talen gesproken.
In deze opgave verstaan we onder sprekers van een taal alleen de
mensen voor wie deze taal hun moedertaal is.
Sommige talen worden door meer dan 100 miljoen mensen gesproken,
maar er zijn ook talen die nog slechts door enkele tientallen mensen
gesproken worden.
Hoe meer mensen een taal spreken, hoe groter we die taal noemen.
Alle aantallen in deze opgave hebben betrekking op het jaar 2010 en zijn
benaderingen op grond van schattingen.
De grootste taal is het Mandarijn met 800 miljoen sprekers.
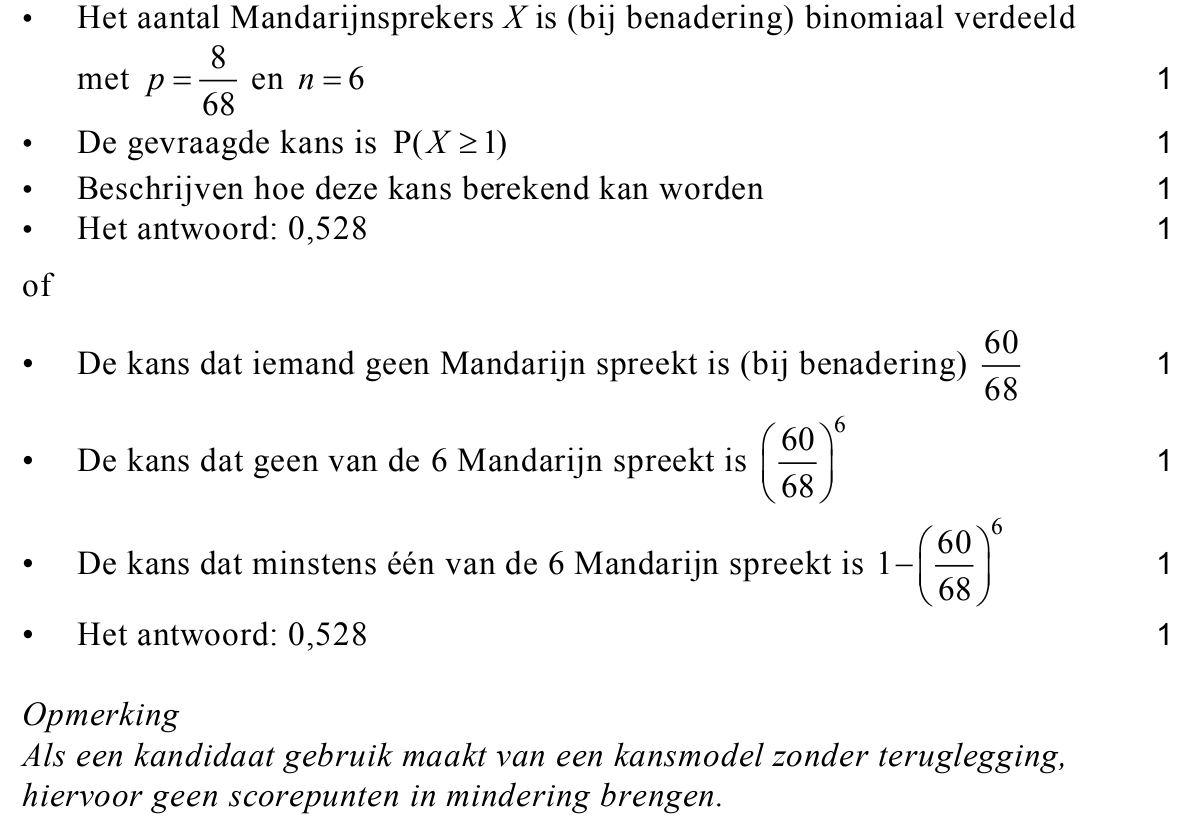
De kans dat van 6 willekeurig gekozen mensen uit de totale
wereldbevolking er minstens één Mandarijn spreekt, is groter dan 0,5.
104pBereken deze kans in drie decimalen nauwkeurig.
Van alle gesproken talen is er een ranglijst waar de talen op volgorde van
veel naar weinig sprekers staan. De top-15 van de meest gesproken talen
in 2010 staat in onderstaande tabel.
tabel

1 Mandarijn 800 000 000 2 Spaans 358 000 000 3 Engels 350 000 000 4 Hindi/Urdu 240 000 000 5 Bengaals 170 000 000 6 Russisch 160 000 000 7 Portugees 150 000 000 8 Arabisch 150 000 000 9 Japans 126 000 000 10 Duits 100 000 000 11 Wu 90 000 000 12 Javaans 70 000 000 13 Punjab 70 000 000 14 Frans 70 000 000 15 Telugu 70 000 000
Deze 15 talen hebben samen 2974 miljoen sprekers. Van de ruim 500
talen zijn er 86 talen met 10 miljoen of meer sprekers. Op de 44e plaats
staat het Nederlands met 20 miljoen sprekers. Hieruit kun je concluderen
dat de talen op de plaatsen 45 tot en met 86 elk minstens 10 miljoen en
hoogstens 20 miljoen sprekers hebben.
Met deze gegevens kun je niet het exacte totaal aantal sprekers van de
86 talen met meer dan 10 miljoen sprekers berekenen. Wel is het mogelijk
om een onder- en een bovengrens van dit aantal te berekenen.
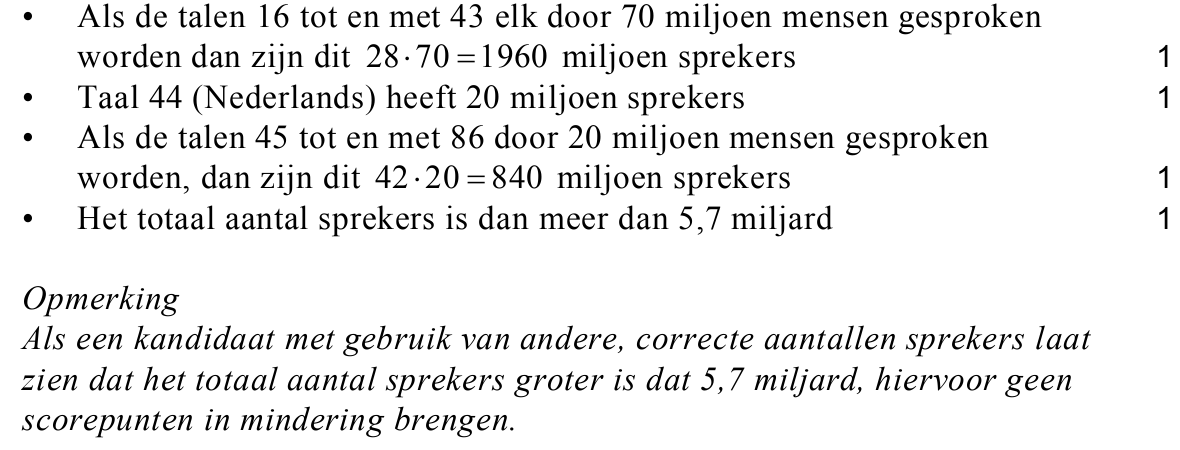
114pLaat zien dat het mogelijk is dat het totaal aantal sprekers van de eerste
86 talen groter is dan 5,7 miljard.
Onderzoekers willen een formule opstellen waarmee het totaal aantal
sprekers van de n grootste talen berekend kan worden als n gegeven is.
Neem aan dat geen enkel tweetal talen precies hetzelfde aantal sprekers
heeft.
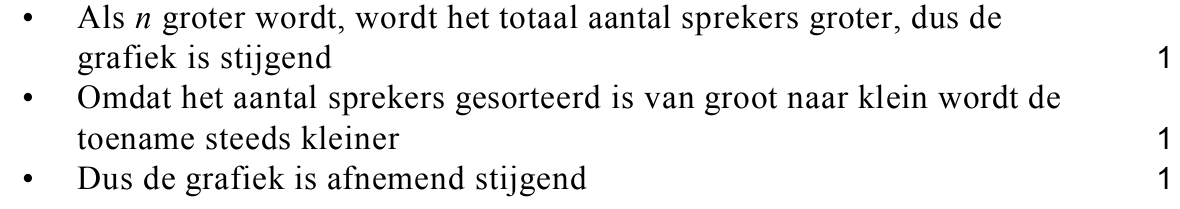
123pBeredeneer dat de grafiek van het totaal aantal sprekers afnemend
stijgend is.
We ordenen de talen van groot naar klein en maken een staafdiagram met
cumulatieve totalen. In onderstaande figuur is het staafdiagram
weergegeven met op de horizontale as het plaatsnummer n van de 30
meest gesproken talen en op de verticale as het totaal aantal sprekers A
in miljarden van de n grootste talen.
figuur
4,0
totaal aantal
sprekers A in 3,5
miljarden van de
n grootste talen 3,0
De 15e staaf in deze figuur geeft aan dat het totaal aantal sprekers van
de 15 grootste talen 2974 miljoen (2,974 miljard) is.
De bovenkanten van de staven kunnen worden benaderd met een
kromme die het verband tussen het totaal aantal sprekers A van de n
grootste talen en n weergeeft. Een benadering van de kromme door de
bovenkanten van de staven wordt gegeven door de formule:
A = 0,92 ⋅ n0,43
Hierbij is n het plaatsnummer van een taal en A het totaal aantal sprekers
in miljarden van de n grootste talen.
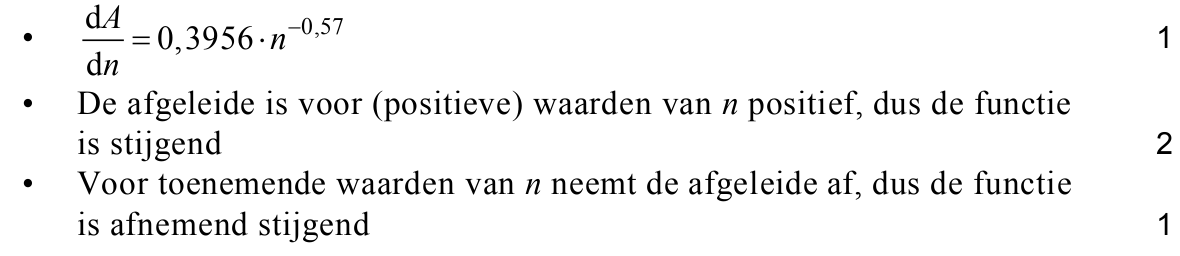
134pToon met behulp van de afgeleide functie aan dat de grafiek van A
inderdaad afnemend stijgend is.
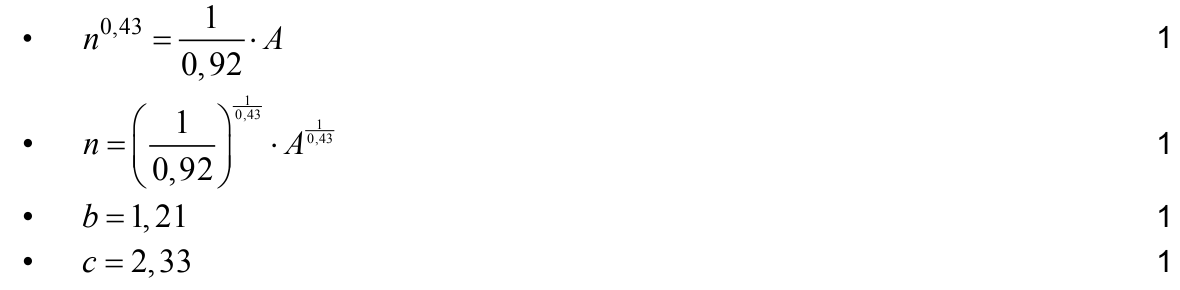
De formule A = 0,92 ⋅ n0,43 kan ook gebruikt worden om te berekenen
hoeveel talen er ten minste nodig zijn om een bepaald aantal mensen in
hun eigen taal te kunnen bereiken. De formule kan hiervoor herleid
worden tot de vorm:
n = b ⋅ Ac
144pBereken b en c. Rond je antwoorden af op twee decimalen.
De formule A = 0,92 ⋅ n0,43 geeft voor kleine waarden van n een redelijke
benadering van A. Een nadeel van deze formule is dat voor grote
waarden van n het totaal aantal sprekers A groter wordt dan de totale
wereldbevolking. Onderzoekers willen daarom een formule gebruiken
waarin de waarde van A niet groter wordt dan 6,8. Daarom stelden zij
voor een formule te gebruiken van de vorm:
A = 6,8(1 − gn)
Ook in deze formule is n het plaatsnummer van een taal en A het totaal
aantal sprekers in miljarden van de n grootste talen.
Er is een waarde van g, waarbij deze nieuwe formule voor de 15 grootste
talen het aantal van 2,974 miljard sprekers oplevert.
154pBereken deze waarde van g in twee decimalen nauwkeurig.
opgave 4Benzineverbruik
Op sommige stukken snelweg staat een bord met de
aansporing ‘Rij schoner, rij 80 in z’n 5.’
Naar aanleiding hiervan onderzocht een journalist hoe
het benzineverbruik van een auto afhangt van de
snelheid en de versnelling waarin de auto rijdt.
De journalist reed ’s nachts 6 keer een afstand van 10 km op een recht
stuk snelweg. Met behulp van cruise control reed hij eerst met
80 km per uur in de derde, vierde en vijfde versnelling en vervolgens met
90 km per uur in de derde, vierde en vijfde versnelling.
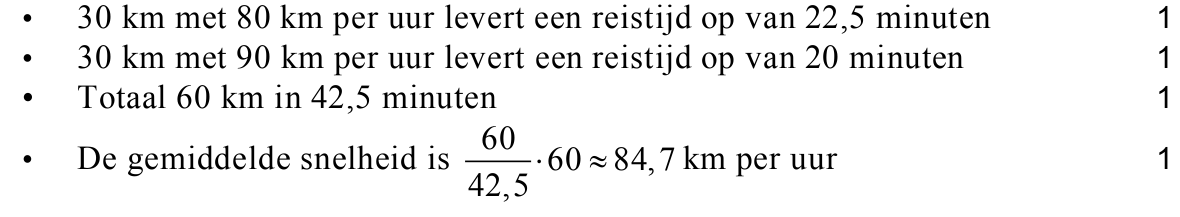
De gemiddelde snelheid van de journalist over de 60 km was niet
85 km per uur.
164pToon aan dat de gemiddelde snelheid afgerond op één decimaal 84,7 km
per uur is.
In de vijfde versnelling is de auto steeds het zuinigst. In de tabel staat de
literafstand L (het aantal kilometer dat je per liter benzine kunt rijden) van
de auto in de vijfde versnelling bij verschillende snelheden. In de tabel
kun je bijvoorbeeld zien dat de literafstand van de auto bij een snelheid
van 80 km per uur 21,62 km is. Dat betekent dat je bij deze snelheid
21,62 km kunt rijden met 1 liter benzine.
tabel
literafstand en de bijbehorende snelheid in de vijfde versnelling
De journalist stelde dat er tot een snelheid van 110 km per uur bij
benadering sprake was van een lineair verband tussen de literafstand L
en de snelheid v.
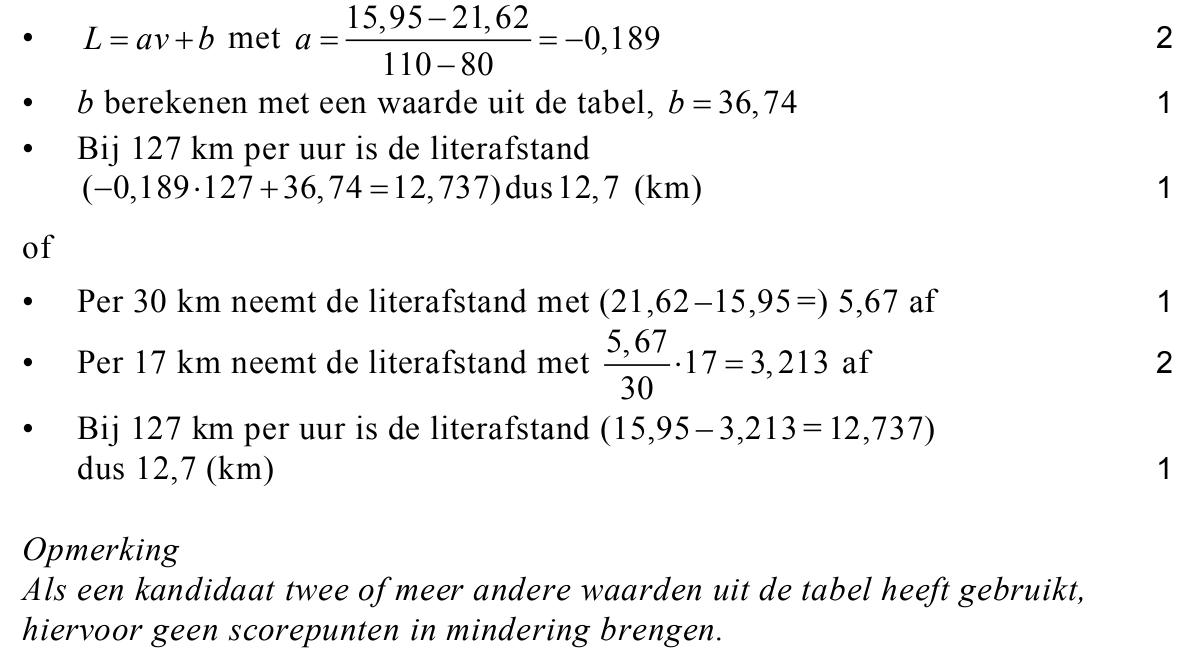
174pBereken met behulp van dit lineaire verband de literafstand bij een
snelheid van 127 km per uur. Rond je antwoord af op één decimaal.
Het verband tussen de literafstand L en de snelheid v blijkt bij een
snelheid boven 110 km per uur niet lineair te zijn.
In een voorlichtingsfolder over zuinig rijden lezen we: ‘Een zuinige
snelheid is 90 km per uur. Als je 120 km per uur rijdt, dan neemt de
literafstand met 30% af. Rijd je 140 km per uur, dan is de literafstand al
met 48% afgenomen.’
Je kunt met bovenstaande gegevens berekenen met hoeveel procent de
literafstand afneemt als de snelheid toeneemt van 120 km per uur naar
140 km per uur.
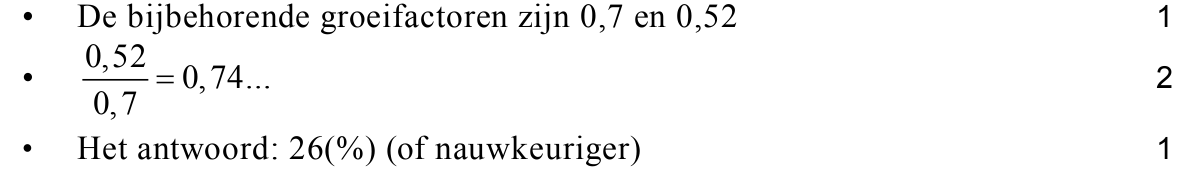
184pBereken dit percentage.
opgave 5Compressie
Zonder dat je het merkt, heb je regelmatig te maken met gecomprimeerde
computerbestanden. Daardoor passen er heel veel nummers op een iPod
en past een hele film op een dvd. We bekijken in deze opgave een
vereenvoudigde compressiemethode.
De rij 000000001111110000001 kan met deze methode gecomprimeerd
worden tot 80616011. In de nieuwe rij wordt elk teken voorafgegaan door
het aantal keren dat het voorkomt:
8 keer een 0, 6 keer een 1, 6 keer een 0 en nog één 1.
De oorspronkelijke rij van 21 tekens is zo teruggebracht tot 8 tekens. Als
het aantal tekens na compressie kleiner is geworden, noemen we de
compressie voordelig.
Voor deze rij is de compressieratio 0,62. De compressieratio kunnen we
als volgt berekenen:
aantaltekensvoor compressie − aantaltekensnacompressie
compressieratio =
aantaltekensvoor compressie
Bekijk de rij 001100110011000111000. Op deze rij wordt bovenstaande
compressiemethode toegepast.
193pBereken de compressieratio van deze rij en geef aan of de compressie
voordelig is.
Een rij met veel dezelfde tekens achter elkaar is natuurlijk beter te
comprimeren dan een rij waarin de tekens vaak wisselen.
Bij een rij waarin de tekens vaak wisselen kan de compressieratio zelfs
negatief worden. Het aantal tekens is dan na compressie groter dan
ervoor.
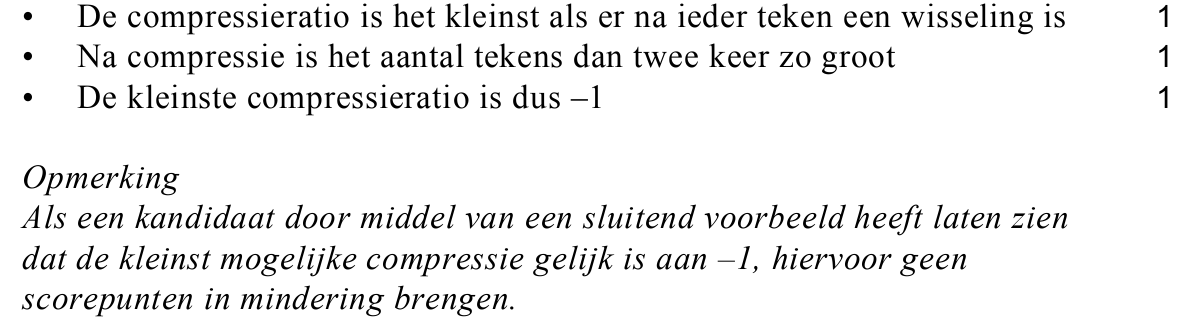
203pOnderzoek wat de kleinste waarde is die de compressieratio volgens de
formule kan aannemen.
Omdat computerbestanden bestaan uit rijen tekens kunnen we hiervan
ook de compressieratio berekenen.
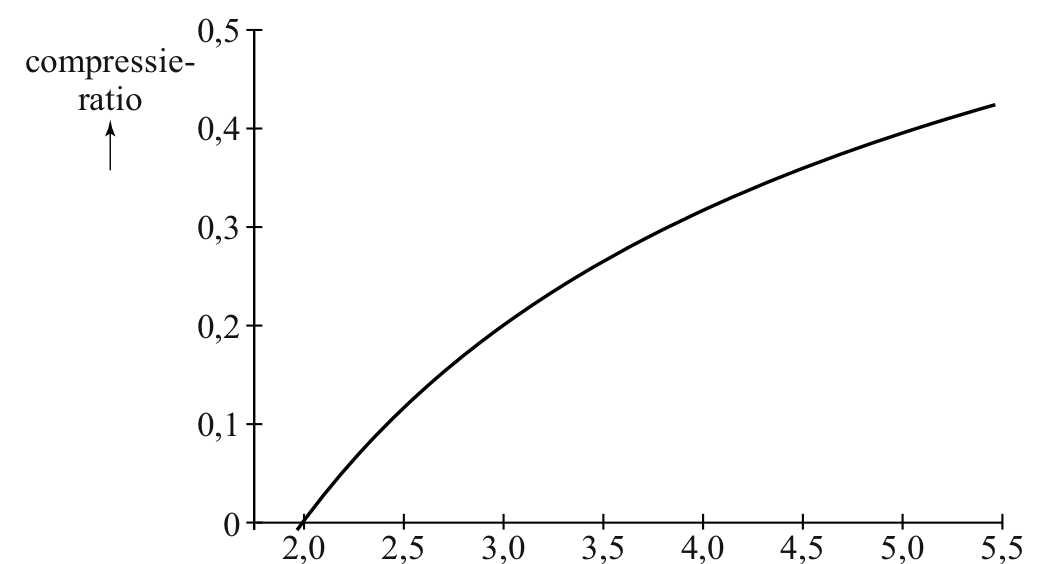
Voor grote bestanden is er een verband tussen de compressieratio en het
gemiddelde aantal gelijke tekens achter elkaar (de gemiddelde
serielengte). Het verband hiertussen is in de figuur weergegeven.
figuur
Bij deze grafiek past de volgende formule:
compressieratio 
Hierin is L de gemiddelde serielengte.
De compressieratio van een bestand is 0,40.
213pBereken met de formule de gemiddelde serielengte van dit bestand. Geef
je antwoord in twee decimalen nauwkeurig.
Informatici doen veel onderzoek naar de compressie van grote bestanden.
Zij genereren met behulp van een toevalsgenerator rijen enen en nullen
om te onderzoeken onder welke omstandigheden compressie voordelig is.
Als de toevalsgenerator zo wordt ingesteld dat de kans op een 0 gelijk is
aan 0,8 en de kans op een 1 gelijk is aan 0,2, dan zal er een behoorlijke
kans zijn dat het begin van een rij uit 3 of meer dezelfde tekens bestaat.